여기까지의 MLflow는 내 노트북 이야기였다. mlflow server를 하나 띄우고, 같은 기계에서 학습 스크립트를 돌리고, 브라우저로 localhost:5000을 열어 결과를 봤다. 혼자 쓸 때 이 구성은 나무랄 데가 없다.
팀원 넷이 같은 서버에 붙는 순간, 성격이 다른 질문이 한꺼번에 쏟아진다. 500MB짜리 체크포인트들은 어디에 쌓이는가? 아티팩트를 S3에 두기로 했다면 S3 키를 팀원 전원에게 뿌려야 하는가? 서버 주소를 아는 사람은 누구나 남의 실험을 지울 수 있는가? Airflow가 돌리는 야간 재학습 DAG는 태스크 세 개로 쪼개져 있는데, 이걸 run 세 개로 남길 것인가 하나로 남길 것인가? 이번 편은 그 질문들에 대한 MLflow 3.15 기준의 답이다.
메타데이터와 파일은 다른 곳에 산다
11편에서 본 저장소 분리가 팀 구성의 출발점이다. Backend store 에는 run·model·trace·experiment의 메타데이터(run ID, 시각, param, metric, tag)가 들어간다. 작고 구조화되어 있으며 “지난주 실험 중 val_loss가 가장 낮은 run”처럼 검색·정렬·인덱싱의 대상이므로 관계형 DB가 맞다. Artifact store 에는 모델 가중치·이미지·데이터 파일 같은 대용량 바이너리가 들어간다. MLflow 입장에서는 내용이 불투명한 덩어리이고 하는 일은 통째로 올리고 내려받는 것뿐이므로 오브젝트 스토리지가 맞다.
접근 패턴이 이렇게 다르니 한 곳에 넣을 이유가 없고, 나누면 각각 독립적으로 스케일·백업·권한 정책을 가져갈 수 있다. Backend store는 SQLAlchemy dialect 4종(sqlite, postgresql, mysql, mssql)을, artifact store는 S3 및 S3 호환(MinIO 등), Azure Blob Storage, GCS, Backblaze B2, FTP/SFTP, NFS, HDFS, 로컬 파일시스템을 지원한다.
파일 스토어의 함정 (2.x 자료를 보고 있다면 특히)
여기가 구버전 지식과 가장 크게 갈리는 지점이다.
MLflow 3.7.0부터 기본 backend store가 파일 기반에서 SQLite로 바뀌었다(self-hosting 문서). 백엔드를 지정하지 않고 서버를 띄우면 ./mlruns 디렉터리가 아니라 sqlite:///mlflow.db가 만들어진다. “MLflow의 기본은 mlruns 폴더”라고 설명하는 자료는 3.7.0 이전 기준이다. 파일시스템 백엔드는 현재 유지보수 모드 라 더 이상 기능 추가를 받지 않고, 아예 안 되는 기능도 있다.
- Model Registry는 DB 백엔드가 필수다. 13편에서 본 등록·버전·alias는 파일 스토어에서는 동작하지 않는다.
- Evaluation Dataset(15편의 GenAI 평가용)도 SQL 백엔드 필수.
- Workspaces(조직 단위 분리 + 권한)도 SQL 백엔드 필수.
- OpenTelemetry ingestion 도 파일 기반 백엔드에서는 지원되지 않는다.
이미 mlruns가 쌓여 있다면 버리지 않고 옮길 수 있다. MLflow 3.10 이상에서 마이그레이션 CLI를 제공한다.
mlflow migrate-filestore --source /path/to/mlruns --target sqlite:///path/to/mlflow.db
mlflow server --backend-store-uri sqlite:///path/to/mlflow.db
단서가 둘 있다. 타깃은 SQLite만 지원한다 (파일 스토어가 만드는 experiment ID가 PostgreSQL/MySQL의 32비트 integer 한계를 넘기 때문이다). 그리고 타깃 DB는 비어 있어야 한다. 다행히 마이그레이션은 옮기는 데이터에 대해 원자적이라, 도중에 실패하면 삽입된 행이 전부 롤백된다 — 안심하고 다시 돌리면 된다.
팀 서버 띄우기
mlflow server의 옵션 중 팀 구성에서 실제로 손대는 것들이다.
| 옵션 | 의미 | 기본값 |
|---|---|---|
--backend-store-uri | 메타데이터 DB(또는 파일) 위치 | sqlite:///mlflow.db |
--artifacts-destination | 서버가 프록시로 대신 읽고 쓸 원격 아티팩트 저장소 | 없음 |
--default-artifact-root | 클라이언트가 직접 접근할 아티팩트 위치 | 프록시 모드면 mlflow-artifacts:/ |
--serve-artifacts / --no-serve-artifacts | 아티팩트 I/O를 서버가 중계할지 | 원격 저장소 사용 시 serving 활성 |
--host | 바인딩 인터페이스 | 127.0.0.1 |
--port | 포트 | 5000 |
--app-name | 인증 앱/플러그인 (basic-auth 등) | 없음 = 인증 없음 |
--host의 기본값을 눈여겨보자. 문서 표현 그대로 서버는 “http://127.0.0.1:5000에서 대기하며 로컬 머신에서 오는 연결만 받는다”. 즉 그냥 띄우면 팀원이 못 붙는다. 팀 서버로 쓰려면 --host 0.0.0.0이 필요하고, 그 순간 접근 제어가 내 문제가 된다(뒤의 인증 절).
PostgreSQL + S3/MinIO 조합의 표준 구성은 이렇다.
# 서버 측 — 아티팩트 저장소 자격증명은 "서버에만" 둔다
export MLFLOW_S3_ENDPOINT_URL=http://localhost:9000   # MinIO 같은 커스텀 엔드포인트
export AWS_ACCESS_KEY_ID=minio_user
export AWS_SECRET_ACCESS_KEY=minio_password

mlflow server \
  --backend-store-uri postgresql://user:password@localhost:5432/mlflowdb \
  --artifacts-destination s3://bucket \
  --host 0.0.0.0 \
  --port 5000
# 클라이언트 측 — 팀원은 이 한 줄이면 끝
export MLFLOW_TRACKING_URI=http://<server-host>:5000프록시 접근 vs 직접 접근 — 팀 운영의 갈림길
위 예제에서 왜 팀원 쪽에는 S3 키가 없어도 되는지가 이 절의 내용이다. MLflow는 아티팩트를 주고받는 경로를 두 가지로 제공하며, 어느 쪽을 고르느냐가 곧 “자격증명을 누구에게 나눠 주는가” 를 결정한다.
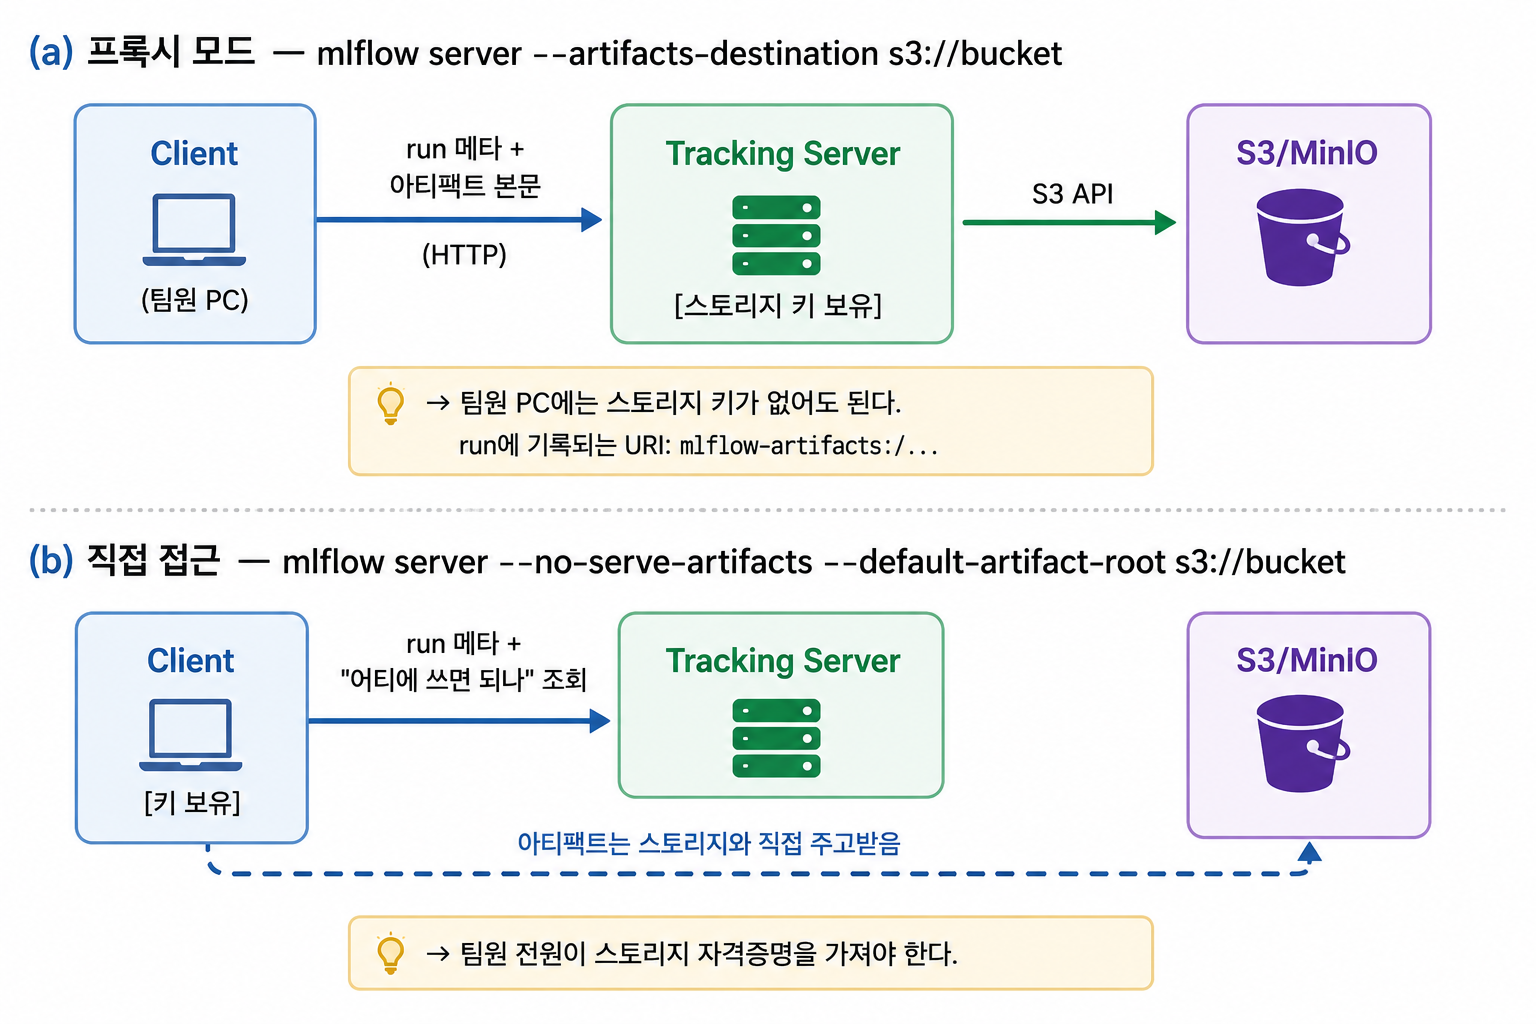
(a)에서는 서버가 대신 원격 저장소를 읽고 쓰고, (b)에서는 클라이언트가 서버에 “저장 위치가 어디냐”만 물은 뒤 스토리지와 직접 주고받는다. 문서가 주는 rule of thumb은 두 줄이다.
- 프록시 업로드를 원하면:
--artifacts-destination을 지정하고--default-artifact-root는 설정하지 않는다.- 클라이언트가 직접 쓰게 하려면:
--default-artifact-root를 지정하고--no-serve-artifacts를 준다.“The two options
--serve-artifactsand--default-artifact-rootlook similar, but they are used for different purposes.”
사내망 팀 운영에서는 보통 (a)가 답이다. 스토리지 자격증명이 서버 한 곳에만 있으면 되므로, 신규 입사자에게 키를 발급하고 퇴사자 키를 회수하는 일이 사라진다. 서버가 데이터 전송의 병목이 되는 것이 걱정된다면 MLFLOW_ENABLE_PROXY_MULTIPART_UPLOAD=true로 presigned URL 멀티파트 업로드를 켤 수 있다 — 이때 파트 데이터는 서버를 통과하지 않고 클라이언트가 스토리지로 직접 올린다.
운영 중 걸리는 것들
스키마 마이그레이션. MLflow를 올리면 backend store 스키마도 바뀔 수 있고, mlflow server는 스키마가 낡은 DB에 대해 실행을 거부한다. 그래서 서버 업그레이드 전에 반드시 돌려야 한다.
mlflow db upgrade postgresql://user:password@localhost:5432/mlflowdb문서의 경고를 그대로 옮기면, 스키마 마이그레이션은 느릴 수 있고 “not guaranteed to be transactional” 이다 — 중간에 깨지면 반쯤 마이그레이션된 DB가 남을 수 있다는 뜻이다. 되돌릴 수 없는 변경도 실제로 있었다(param 최대 길이 500자 → 8k자 확대). 백업이 먼저다.
큰 아티팩트 타임아웃. 수 GB짜리 체크포인트를 프록시 모드로 올리다 끊긴다면 워커 타임아웃을 늘린다.
mlflow server --uvicorn-opts "--timeout-keep-alive=120"
# 또는
mlflow server --gunicorn-opts "--timeout=120"
인증 — 기본 상태는 무방비다
짚고 갈 것: 아무 옵션 없이 띄운 MLflow 서버에는 인증이 없다. --host 0.0.0.0으로 열어 두면 네트워크가 닿는 누구나 실험을 보고 지울 수 있다.
가장 간단한 대응은 내장 basic HTTP auth다.
export MLFLOW_FLASK_SERVER_SECRET_KEY="my-secret-key"   # CSRF 보호용, 필수
mlflow server --app-name basic-auth
켜면 experiment·registered model·scorer를 보려면 로그인해야 한다. 권한은 READ, USE, EDIT, MANAGE, NO_PERMISSIONS 5단계이고 기본은 READ다. 초기 관리자 계정이 admin / password1234로 만들어지므로 생성 직후 반드시 바꾼다 (문서도 같은 권고를 한다). 클라이언트는 MLFLOW_TRACKING_USERNAME/MLFLOW_TRACKING_PASSWORD 환경변수나 ~/.mlflow/credentials 파일로 인증하는데, 이 파일은 암호화되지 않는다. HTTP 인증의 성격상 원격 tracking server에서만 지원된다.
사내 SSO를 붙이고 싶다면, OIDC는 OSS 코어에 내장되어 있지 않다. 커뮤니티 플러그인 mlflow-oidc-auth를 쓰거나, oauth2-proxy 같은 reverse proxy 앞단에서 인증을 끝내고 identity 헤더를 붙여 전달하는 방식이다. 문서 자체가 프로덕션에서는 reverse proxy(NGINX, Apache httpd)로 TLS를 씌우거나 VPN 안에 두기를 권장한다. --host 0.0.0.0을 쓸 때는 --allowed-hosts로 접근 도메인을 제한하라는 안내도 함께 있다.
여러 팀이 한 서버를 나눠 쓴다면 Workspaces 가 선택지다. experiment·registered model·prompt·artifact 등을 조직 단위로 묶고 그 위에 권한(READ/USE/MANAGE)을 거는 계층으로, MLflow 3.10.0에서 도입되고 3.13.0에서 역할 기반 접근 제어(RBAC)가 붙었다. 기본은 꺼져 있고(--enable-workspaces로 opt-in), SQL 백엔드가 필요하다. 리소스 단위 권한이 워크스페이스 권한보다 우선한다.
Airflow와 엮기 — 태스크 여러 개를 run 하나로
이제 7~9편에서 만든 DAG와 연결할 차례다. 문제 상황은 이렇다. 전처리·학습·평가가 각각 별개 태스크(= 별개 프로세스, KubernetesPodOperator라면 별개 Pod)로 도는데, 이들은 논리적으로 하나의 파이프라인 실행이다. 태스크마다 mlflow.start_run()을 부르면 run이 세 개로 흩어지고, “이 모델의 전처리 파라미터가 뭐였지”를 보려면 세 run을 손으로 이어 붙여야 한다.
MLflow의 답은 run을 재개하는 것 이다. mlflow.start_run(run_id=...)에 기존 run ID를 주면 그 run에 이어서 기록한다. 첫 태스크가 만든 run_id를 Airflow XCom으로 다음 태스크에 넘기거나, 태스크 컨테이너에 MLFLOW_RUN_ID 환경변수로 주입하면 된다(둘 다 문서화된 경로이고, run_id 인자가 환경변수보다 우선한다).
# task 1: 전처리 — run 생성
with mlflow.start_run(run_name="daily-pipeline") as run:
    mlflow.log_param("window_days", 7)
    run_id = run.info.run_id      # XCom으로 push

# task 2: 학습 — 같은 run 이어 붙이기
with mlflow.start_run(run_id=run_id):
    mlflow.log_metric("train_loss", 0.12)

# task 3: 평가 — 역시 같은 run에 model·metric 추가
with mlflow.start_run(run_id=run_id):
    mlflow.log_metric("test_auc", 0.87)
주의할 점이 두 가지 있고, 둘 다 처음 겪으면 당황스럽다.
- 재개할 때 다른 인자는 무시된다. 문서 표현대로 “attempts to resume a run with the specified run ID and other parameters are ignored”이므로,
run_id와 함께run_name이나tags를 넘겨도 반영되지 않는다. run 이름·태그는 첫 태스크에서 확정해야 한다. - run 상태가 오르내린다.
with블록을 빠져나올 때마다 run은FINISHED가 되고, 다음 태스크가 재개하면 다시RUNNING으로 돌아간다. 중간에 UI를 보면 “끝난 것처럼” 보일 수 있으니 상태만으로 파이프라인 진행을 판단하지 않는다.
각 단계를 따로 보고 싶다면 대안으로 단계별 nested run(부모 run 아래 자식 run)을 두는 구조도 있다. 어느 쪽이든, MLflow에는 Airflow 전용 공식 통합 가이드가 없다 — run_id를 넘기는 이 방식이 문서에 근거를 둔 표준 해법이다.
Lineage — 나중에 “이 모델 뭐로 학습했지”에 답하기
파이프라인이 자동으로 돌기 시작하면, 몇 달 뒤 반드시 이 질문이 온다. 미리 남겨 둘 것은 셋이다.
데이터셋. mlflow.data로 데이터셋 객체를 만들어 run에 연결한다.
dataset = mlflow.data.from_pandas(df, source="https://example.com/data.csv", name="my-dataset")
with mlflow.start_run():
    mlflow.log_input(dataset, context="training")
기록되는 것은 name, digest, source, schema, profile 이다. 핵심은 digest — 자동 계산된 해시라, 두 run이 정말 같은 데이터를 썼는지 이름이 아니라 내용으로 판정할 수 있다. pandas 외에 Spark·NumPy·Polars·HuggingFace·TensorFlow 데이터셋도 지원한다.
코드. 별도 조치 없이 시스템 태그로 붙는다 — mlflow.source.name(실행 파일/노트북), mlflow.source.type, mlflow.user, git 저장소 안이라면 mlflow.source.git.commit까지.
환경. 모델을 로깅하면 python_env.yaml·requirements.txt·conda.yaml이 자동 생성된다. 목록은 flavor 라이브러리에서 추론해 채워지는데, 여기에 더해 input_example을 넣으면 MLflow가 저장 전에 실제 예측을 한 번 돌려 그때 사용된 의존성까지 포착한다. 정적 추론은 빠뜨리는 것이 생기기 마련이라, 13편에서 강조한 input_example 습관이 재현성에서도 값을 한다. 배포 전 검증은 이렇게 한다.
mlflow.models.predict(model_uri=model_info.model_uri, input_data="<input_data>")
# model_uri에는 "models:/<name>@<alias>" 같은 registry URI도 그대로 쓸 수 있다
기록된 의존성으로 가상환경을 새로 만들어 격리 실행하므로, 추론 서버를 띄우지 않고도 “이 환경 목록만으로 모델이 실제로 뜨는가”를 확인할 수 있다.
다음 15편에서는 MLflow 3이 LLM 앱과 에이전트를 위해 새로 붙인 tracing·evaluation·prompt registry를 본다.
요약
- MLflow 서버는 backend store(작고 검색 대상인 메타데이터 → 관계형 DB)와 artifact store(크고 불투명한 파일 → 오브젝트 스토리지)를 접근 패턴이 달라서 나눠 쓴다. MLflow 3.7.0부터 기본 backend store는 파일이 아니라 SQLite다. 파일 백엔드는 유지보수 모드이고 Model Registry·Evaluation Dataset·Workspaces는 DB 백엔드가 필수이며, 기존
mlruns는 3.10+의mlflow migrate-filestore로 옮긴다(타깃은 SQLite만). --host기본값이127.0.0.1이라 그냥 띄우면 팀원이 붙지 못한다. 아티팩트는 프록시 모드(--artifacts-destination, 자격증명이 서버에만) 와 직접 접근(--no-serve-artifacts --default-artifact-root, 전원이 키 보유) 중 하나를 고르며, 사내 팀 운영에서는 보통 프록시가 답이다.- 업그레이드 전
mlflow db upgrade를 돌리되 백업이 먼저(트랜잭션이 보장되지 않는다). 기본 서버에는 인증이 없으므로 basic auth·reverse proxy(TLS)·VPN 중 하나는 필요하다. - Airflow에서 태스크 여러 개를 한 run으로 묶으려면
run_id를 XCom이나MLFLOW_RUN_ID로 넘겨mlflow.start_run(run_id=...)로 재개한다. 재개 시 다른 인자는 무시되고, run 상태는 FINISHED↔RUNNING을 오간다. - Lineage는
log_input(데이터셋 digest), 자동 git 태그, 자동 생성 환경 파일로 남기며 —input_example을 넣으면 실제 예측을 한 번 돌려 의존성을 포착한다. 배포 전mlflow.models.predict()로 격리 검증.
참고문헌
- Tracking Server — 서버 옵션, 프록시 vs 직접 아티팩트 접근.
- Backend Stores · Artifact Stores — 지원 백엔드와
mlflow db upgrade. - Migrate from File Store · Remote Server 튜토리얼.
- Basic HTTP Auth · SSO · Workspaces.
- Datasets · Model Dependencies — lineage와 환경 재현.
이전 글: 13. 모델을 자산으로 만들기 — Model과 Registry 다음 글: 15. MLflow 3와 GenAI — tracing·evaluation·prompt registry