10편은 Docker·Kubernetes·Airflow가 MLOps의 뼈대를 이루고, “그 위에 실험 추적·모델 레지스트리 같은 도구들이 더 얹힌다”는 말로 끝났다. 이번 글부터 그 얹히는 층을 하나 열어 본다. 주인공은 MLflow 다.
왜 이 층이 필요한지는 겪어 보면 안다. 모델을 몇 개 돌려 보다 보면 디렉터리에는 model_v3_final_real.pkl이 쌓이고, 하이퍼파라미터는 엑셀 시트에, 성능 숫자는 슬랙에 올린 스크린샷에 남는다. 그러다 두 달 뒤 누군가 묻는다. “지난번에 정확도 0.91 나왔던 그거, 어떤 설정이었죠?” 이 질문에 답할 수 없다면, 그 0.91은 사실 존재하지 않았던 것이나 마찬가지다. 재현할 수 없는 결과는 자산이 아니다.
시리즈 첫 글에서 Docker가 환경 의 재현성을 풀었다면, MLflow는 실험 의 재현성을 푼다. “이 코드가 어디서나 똑같이 돈다”와 “그때 그 숫자가 어떤 코드·데이터·설정에서 나왔는지 되짚을 수 있다”는 다른 문제다. 이 글은 MLflow 3.15 기준 으로 후자를 다룬다. 2.x 코드와 달라진 지점은 그때그때 짚는다.
MLflow가 덮는 범위
현행 MLflow 문서는 크게 두 트랙으로 나뉜다. 하나는 LLM·에이전트 관측과 프롬프트 관리를 다루는 트랙이고, 다른 하나가 우리가 볼 Machine Learning 트랙 이다. ML 트랙은 다시 실험 추적(Tracking & Experiments), 모델 레지스트리(Model Registry), 모델 배포(Model Deployment), 라이브러리 통합, 평가로 구성된다.
실무 관점에서 정리하면 MLflow는 네 가지 축을 제공한다.
- 실험 추적 — 무엇을 어떤 설정으로 돌려 어떤 결과가 나왔는지 기록한다. (이번 편)
- 모델 패키징 — 학습된 모델을 “입출력 계약 + 의존성”과 함께 표준 포맷으로 저장한다.
- 모델 레지스트리 — 그렇게 만든 모델에 이름·버전을 붙여 조직의 자산으로 관리한다.
- 배포 — 그 모델을 REST 서버나 컨테이너 이미지로 내보낸다.
참고로 2.x 시절 자료에 자주 등장하던 파이프라인 도구 MLflow Recipes는 MLflow 3에서 완전히 제거됐다. 오래된 튜토리얼을 따라가다 막히는 흔한 지점이다.
아키텍처 — client, tracking server, 두 개의 store
MLflow의 구조는 단순하다. 학습 스크립트가 client가 되어 서버에 기록을 보내고, 서버는 그것을 두 종류의 저장소에 나눠 담는다.
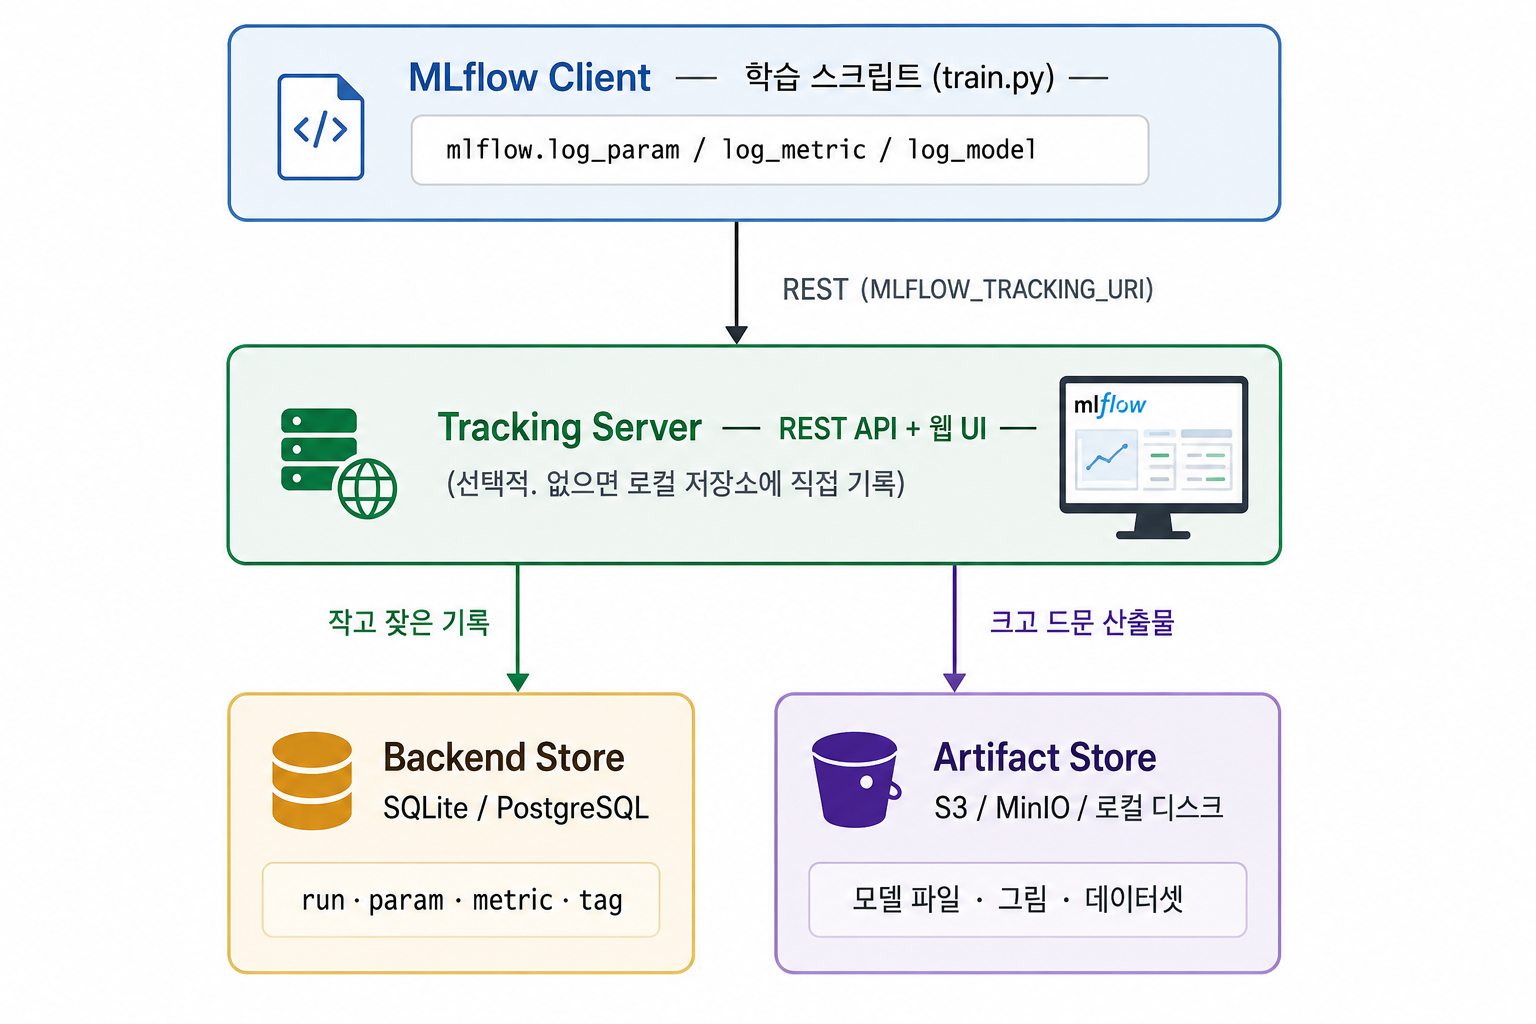
두 저장소를 나눈 이유가 핵심이다. backend store 에는 검색·비교의 대상이 되는 작은 구조화 데이터(run ID, 파라미터, 지표, 태그)가 들어가므로 데이터베이스가 맡는다. artifact store 에는 수백 MB짜리 모델 가중치나 그림 파일처럼 크고 자주 조회하지 않는 것이 들어가므로 오브젝트 스토리지가 맡는다. 조직 규모로 쓸 때 backend는 동시성 때문에 PostgreSQL·MySQL을 권장한다.
여기서 버전 함정이 하나 있다. MLflow 3.7.0부터 기본 backend store가 파일 기반 ./mlruns에서 SQLite(sqlite:///mlflow.db)로 바뀌었다. “기본은 mlruns 폴더”라고 설명하는 옛 자료를 그대로 믿으면 안 된다.
어휘 — experiment, run, param, metric, artifact, tag
MLflow를 쓴다는 것은 사실상 이 여섯 단어로 내 실험을 표현하는 일이다.
- Experiment — run과 model을 담는 상위 묶음. 문서 표현으로는 “특정 작업 단위(specific task)“로 묶는 폴더에 가깝다.
- Run — 코드 한 번의 실행. 실험 기록의 기본 단위다.
- Param — 그 run의 입력 설정.
learning_rate,max_depth처럼 실행 전에 정해지는 값. 한 번 쓰면 바뀌지 않는다. - Metric — 그 run의 출력 결과. accuracy, loss처럼 실행 중·후에 측정되는 수치. 시간에 따라 여러 번 찍을 수 있다.
- Artifact — 파일 형태의 산출물. 모델 파일, confusion matrix 그림, 평가 리포트 CSV.
- Tag — run에 붙이는 자유로운 key-value 라벨. 나중에 검색으로 되찾기 위한 색인이다.
param과 metric의 구분이 헷갈리는데, 기준은 간단하다. 내가 정해서 넣은 값이면 param, 돌려 봐야 아는 값이면 metric 이다.
metric이 param과 결정적으로 다른 점은 step 인자다.
for epoch in range(n_epochs):
    train_loss = train_one_epoch(...)
    val_acc = evaluate(...)
    mlflow.log_metric("train_loss", train_loss, step=epoch)
    mlflow.log_metric("val_acc", val_acc, step=epoch)
같은 이름의 metric을 step을 바꿔 가며 여러 번 찍으면 MLflow UI가 그것을 학습 곡선 으로 그려 준다. 최종 정확도 하나만 남기면 “언제부터 과적합이 시작됐는가”를 나중에 볼 수 없다. step 축은 그래서 공짜로 얻는 진단 도구다.
최소 예제 — sklearn 한 판
서버부터 띄운다.
mlflow server --port 5000그리고 학습 스크립트에서 그 서버를 가리키고 experiment를 고른 뒤, start_run() 블록 안에서 기록한다.
import mlflow
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

mlflow.set_tracking_uri("http://localhost:5000")
mlflow.set_experiment("iris-baseline")

X, y = load_iris(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
params = {"solver": "lbfgs", "max_iter": 1000, "random_state": 42}

with mlflow.start_run(run_name="lr-baseline"):
    mlflow.log_params(params)

    lr = LogisticRegression(**params)
    lr.fit(X_train, y_train)

    model_info = mlflow.sklearn.log_model(
        sk_model=lr, name="iris_model", input_example=X_train.iloc[[0]]
    )

    accuracy = accuracy_score(y_test, lr.predict(X_test))
    mlflow.log_metric("accuracy", accuracy)
    mlflow.set_tag("Training Info", "Basic LR model for iris data")

loaded_model = mlflow.pyfunc.load_model(model_info.model_uri)
predictions = loaded_model.predict(X_test)
with 블록을 빠져나오면 run이 자동으로 종료된다. http://localhost:5000에 접속하면 iris-baseline experiment 안에 lr-baseline run이 하나 생기고, 파라미터·정확도·저장된 모델이 모두 붙어 있다. 마지막 두 줄이 중요한데, 저장한 모델을 경로 문자열이 아니라 model_info.model_uri로 다시 불러오는 것 이 MLflow 3의 공식 권고다.
MLflow 3의 변화 — 모델이 1급 시민이 됐다
여기서 2.x 코드와 갈라지는 지점을 반드시 짚어야 한다. 위 예제의 log_model(..., name="iris_model")을 2.x 자료들은 log_model(..., artifact_path="iris_model")로 쓴다. 단순한 이름 변경이 아니라 데이터 모델이 바뀐 결과다.
- 2.x: 모델은 run의 하위 아티팩트였다. 그래서 “어느 경로에 저장할지”를 뜻하는
artifact_path가 자연스러웠다. - 3.x: 모델은
LoggedModel이라는 1급 엔티티 다. 릴리스 노트 표현으로 “a first-class citizen, moving beyond the traditional run-centric approach”. LoggedModel은 run이 아니라 experiment에 직접 소속 되고(experiment_id), 자신을 만들어 낸 run과는source_run_id로 느슨하게 연결될 뿐이다.
여기서 따라 나오는 실질적 차이가 셋이다.
artifact_path는 deprecated이고name을 쓴다. 2.x 코드를 복사해 쓰다 막히는 1순위 지점이다.mlflow.start_run()컨텍스트 없이도log_model()을 호출할 수 있다. 모델이 run에 종속되지 않기 때문이다.- LoggedModel은 자기 자신의
params·metrics·tags를 가진다. run의 것과 별개다.log_metric(..., model_id=...)처럼 지표를 특정 모델에 귀속시킬 수 있고, 이것이 MLflow 3가 내세우는 “모델 중심 lineage”의 API 기반이다.
덕분에 한 run 안에서 여러 체크포인트를 각각 별도의 모델로 남기는 것도 자연스러워졌다.
model_info = mlflow.pytorch.log_model(
    pytorch_model=model, name=f"checkpoint-epoch-{epoch}", step=epoch,
    input_example=sample_input,
)
새 URI 스킴 models:/<model_id>도 이때 생겼다. 저장 구조 자체가 run 기반에서 전용 model 디렉터리로 바뀌었기 때문에, MlflowClient.list_artifacts()로 모델 파일을 뒤지던 옛 코드도 동작이 달라진다.
autolog — 시작은 자동으로, 마무리는 손으로
지금까지는 손으로 다 찍었다. 하지만 mlflow.autolog() 한 줄, 또는 라이브러리별 mlflow.sklearn.autolog() 한 줄이면 상당 부분이 자동으로 남는다. sklearn의 경우 문서가 명시하는 자동 기록 항목은 이렇다.
- Parameters —
estimator.get_params(deep=True)가 반환하는 전체 설정 - Training metrics — estimator의
score. 분류기는 precision/recall/f1/accuracy, 회귀는 MSE/RMSE/MAE/R² - Tags — estimator의 클래스명과 fully qualified 클래스명
- Artifacts — 학습된 estimator를 담은 MLflow Model (
predict()가 있으면 pyfunc flavor도 함께) - 파라미터 서치 —
GridSearchCV같은 서치는 parent/child run 구조를 자동 생성하고, child에 조합별 CV score를, best estimator를 별도로 로깅
자동 지원되는 라이브러리는 문서 기준 tensorflow(Keras 포함), lightgbm, paddle, pyspark.ml, pytorch, sklearn, spark, statsmodels, xgboost 9종이다.
다만 문서가 스스로 밝히는 한계가 있고, 이것만은 알고 써야 한다.
- 버전 호환 범위가 있다. sklearn은
1.5.2 <= scikit-learn <= 1.9.0에서 호환이 확인됐고, 범위 밖에서는 autolog가 실패할 수 있다. - PyTorch는 Lightning으로 학습한 모델만 지원한다. 게다가
Trainer.fit()에 명시적으로 넘기지 않은 기본값 파라미터는 기록되지 않는다. 다중 optimizer면 첫 optimizer 것만 남는다. - Spark는 비동기로 동작해 수명이 짧은 run과 race condition이 생길 수 있다.
- 끄려면
mlflow.sklearn.autolog(disable=True).
여기서 결론이 나온다. autolog로 시작하되, 거기서 멈추면 안 된다. autolog가 잡는 것은 라이브러리가 알고 있는 것뿐이다. 반대로 진짜 중요한 축 — 도메인 KPI(예: 반도체 FAB이라면 평균 사이클 타임이나 납기 준수율), 추론 지연시간, 비용, 그리고 어떤 데이터 스냅샷으로 학습했는가 — 는 라이브러리가 알 리 없으므로 결국 내가 직접 log_metric·log_param으로 찍어야 한다. 자동 기록은 바닥을 깔아 줄 뿐, 두 달 뒤의 나를 구하는 것은 손으로 남긴 그 몇 줄이다.
요약
- MLflow는 Docker가 푼 환경의 재현성 위에 실험의 재현성 을 얹는 도구다. 기록이 없으면 “그때 그 0.91”은 자산이 아니다.
- 구조는 client → tracking server → backend store(작은 메타데이터) + artifact store(큰 산출물). MLflow 3.7.0부터 기본 backend store는 파일이 아니라 SQLite다.
- 어휘는 experiment / run / param(입력) / metric(출력,
step축 가능) / artifact / tag. metric의step이 학습 곡선을 만든다. - MLflow 3의 최대 변화는
LoggedModel— 모델이 run의 하위 아티팩트가 아니라 experiment 소속 1급 엔티티가 됐다.log_model(artifact_path=)는log_model(name=)으로 바뀌었고,start_run()없이도 호출된다. autolog()는 파라미터·기본 지표·모델을 자동으로 남기지만 버전 호환 범위와 프레임워크별 한계가 있다. 도메인 지표와 데이터 버전은 결국 직접 찍어야 한다.- 다음 편 실험을 관리 가능하게 만들기에서는, 기록이 쌓인 뒤에 오는 진짜 문제 — 찾을 수 있게 기록하기 — 를 다룬다.
참고문헌
- MLflow Tracking — 아키텍처와 tracking API.
- MLflow Quickstart — 위 sklearn 예제의 원본.
- MLflow 3 — LoggedModel과 2.x 마이그레이션.
- Automatic Logging — 지원 라이브러리와 명시된 한계.
이전 글: 10. 셋을 잇기 — Docker·Kubernetes·Airflow가 만나는 MLOps 파이프라인 다음 글: 12. 실험을 관리 가능하게 만들기