지난 몇 년간 AI의 발전 서사는 단순했다. 모델을 키우면 성능이 오른다. 그런데 이 서사가 부딪힌 벽은 알고리즘이 아니라 전기요금과 열 이었다. AI+HW 2035: Shaping the Next Decade (arXiv:2603.05225, 2026)는 이 문제를 정면으로 다루면서, 앞으로 10년간 AI와 하드웨어가 어떻게 함께 진화해야 하는지에 대한 로드맵을 제시한다.
이 글은 4편 시리즈의 첫 번째로, 논문이 왜 “급진적 변화”를 요구하는지와 그 뼈대가 되는 3계층 공진화 구조를 정리한다.
이 논문의 성격부터 짚고 가자
먼저 분명히 해둘 것이 있다. 이것은 새로운 기법을 제안하고 실험으로 검증하는 일반적인 연구 논문이 아니다. NSF가 후원한 동명의 워크숍 결과물이며, 참가자 각자가 발표한 관점을 모아 정리한 비전 페이퍼(vision paper) 다.
저자 명단이 이 논문의 성격을 잘 말해준다. 교신저자는 Deming Chen(UIUC)과 Ruchir Puri(IBM Research)이고, 저자 30인에는 학계에서 Jason Cong(UCLA), Kunle Olukotun(Stanford/SambaNova), Subhasish Mitra(Stanford), Tri Dao(Princeton/Together AI), Yann LeCun(NYU) 등이, 산업계에서 NVIDIA·Google·AMD·IBM·Synopsys·OpenAI·SK Hynix·SambaNova·EnCharge AI 등의 인사가 포함되어 있다. 알고리즘, 컴퓨터 구조, EDA(전자 설계 자동화), 메모리, 시스템이 한자리에 모인 구성이다. (소속은 논문 표지의 표기를 따랐다.)
따라서 이 글에 나오는 “1000× 효율 개선”, “5년 내 전력 부족” 같은 숫자는 측정된 결과가 아니라 저자들이 합의한 예측이자 목표 로 읽어야 한다. 논문 스스로도 이 문서를 “살아있는 참조 문헌(living reference)“으로 삼아 커뮤니티 의견을 계속 반영하겠다고 밝힌다.
문제: 무엇이 진짜 벽인가
논문이 진단하는 현재 상황은 세 가지로 요약된다.
1. 연산이 아니라 데이터 이동이 병목이다
오늘날의 컴퓨팅 인프라는 여전히 compute-centric 이다. 즉 연산 유닛과 데이터 저장소가 분리되어 있다. 그 결과 생기는 것이 잘 알려진 메모리 벽(memory wall)이고, 논문은 이제 데이터를 옮기는 데 드는 에너지가 데이터를 계산하는 데 드는 에너지를 초과했다 고 못박는다.
이것이 왜 중요한가. 연산기를 아무리 빠르게 만들어도, 병목이 데이터 이동에 있다면 성능은 거의 오르지 않기 때문이다. 우물에서 물을 긷는 시간이 대부분인데 양동이를 더 큰 것으로 바꾸는 격이다.
2. AI와 하드웨어의 혁신 속도가 어긋나 있다
AI 모델과 알고리즘은 개월 단위로 진화하는데, 하드웨어는 연 단위로 진화한다. 이 불일치가 만들어내는 결과를 논문은 이렇게 표현한다.
오늘의 알고리즘은 어제의 시스템을 전제로 설계되고, 내일의 칩은 오늘의 워크로드에 최적화된다.
그래서 알고리즘 연구자는 고정된 하드웨어에 자기 모델을 억지로 맞추고, 칩 설계자는 아직 존재하지도 않는 워크로드를 추측해서 설계한다. 양쪽 모두 손해다.
3. 에너지 소비가 지속 가능하지 않다
프런티어 모델 한 번의 학습이 수백 가구 분량의 에너지를 소비하고, AI 데이터센터의 전력 수요가 국가 단위와 견줄 수준에 이르렀다는 것이 논문의 지적이다. 그리고 이 추세대로면 이번 10년이 끝날 무렵(2030년경) 에는 프런티어 모델 한 개의 학습이 국가 전체가 쓰는 에너지에 필적 할 수 있다고 본다.
해법의 방향: scaling의 재정의
논문의 핵심 주장은 한 문장으로 압축된다.
AI의 미래는 지능을 키우는 스케일링이 아니라, 효율을 키우는 스케일링 에 달려 있다.
여기서 새로 제시되는 지표가 intelligence per joule (줄당 지능)이다. 논문은 이를 “에너지 단위당 얻어지는 의미 있는 능력, 통찰, 또는 과업 성능”으로 정의한다. FLOPs도 아니고 파라미터 수도 아니다. 같은 맥락에서 논문은 intelligence per dollar 와 intelligence per second 도 1급 목표로 함께 다뤄야 한다고 말한다.
그리고 이 방향의 구체적 목표가 10년 내 학습·추론 효율 1000× 개선 이다. 이 숫자를 어떻게 달성한다는 것인지, 얼마나 현실적인지는 4편에서 다룬다.
3계층 공진화 구조
논문의 뼈대는 Figure 1에 나오는 세 개의 추상화 계층이다. 중요한 것은 이것이 위에서 아래로 흐르는 단방향 스택이 아니라 양방향 피드백 루프 라는 점이다.
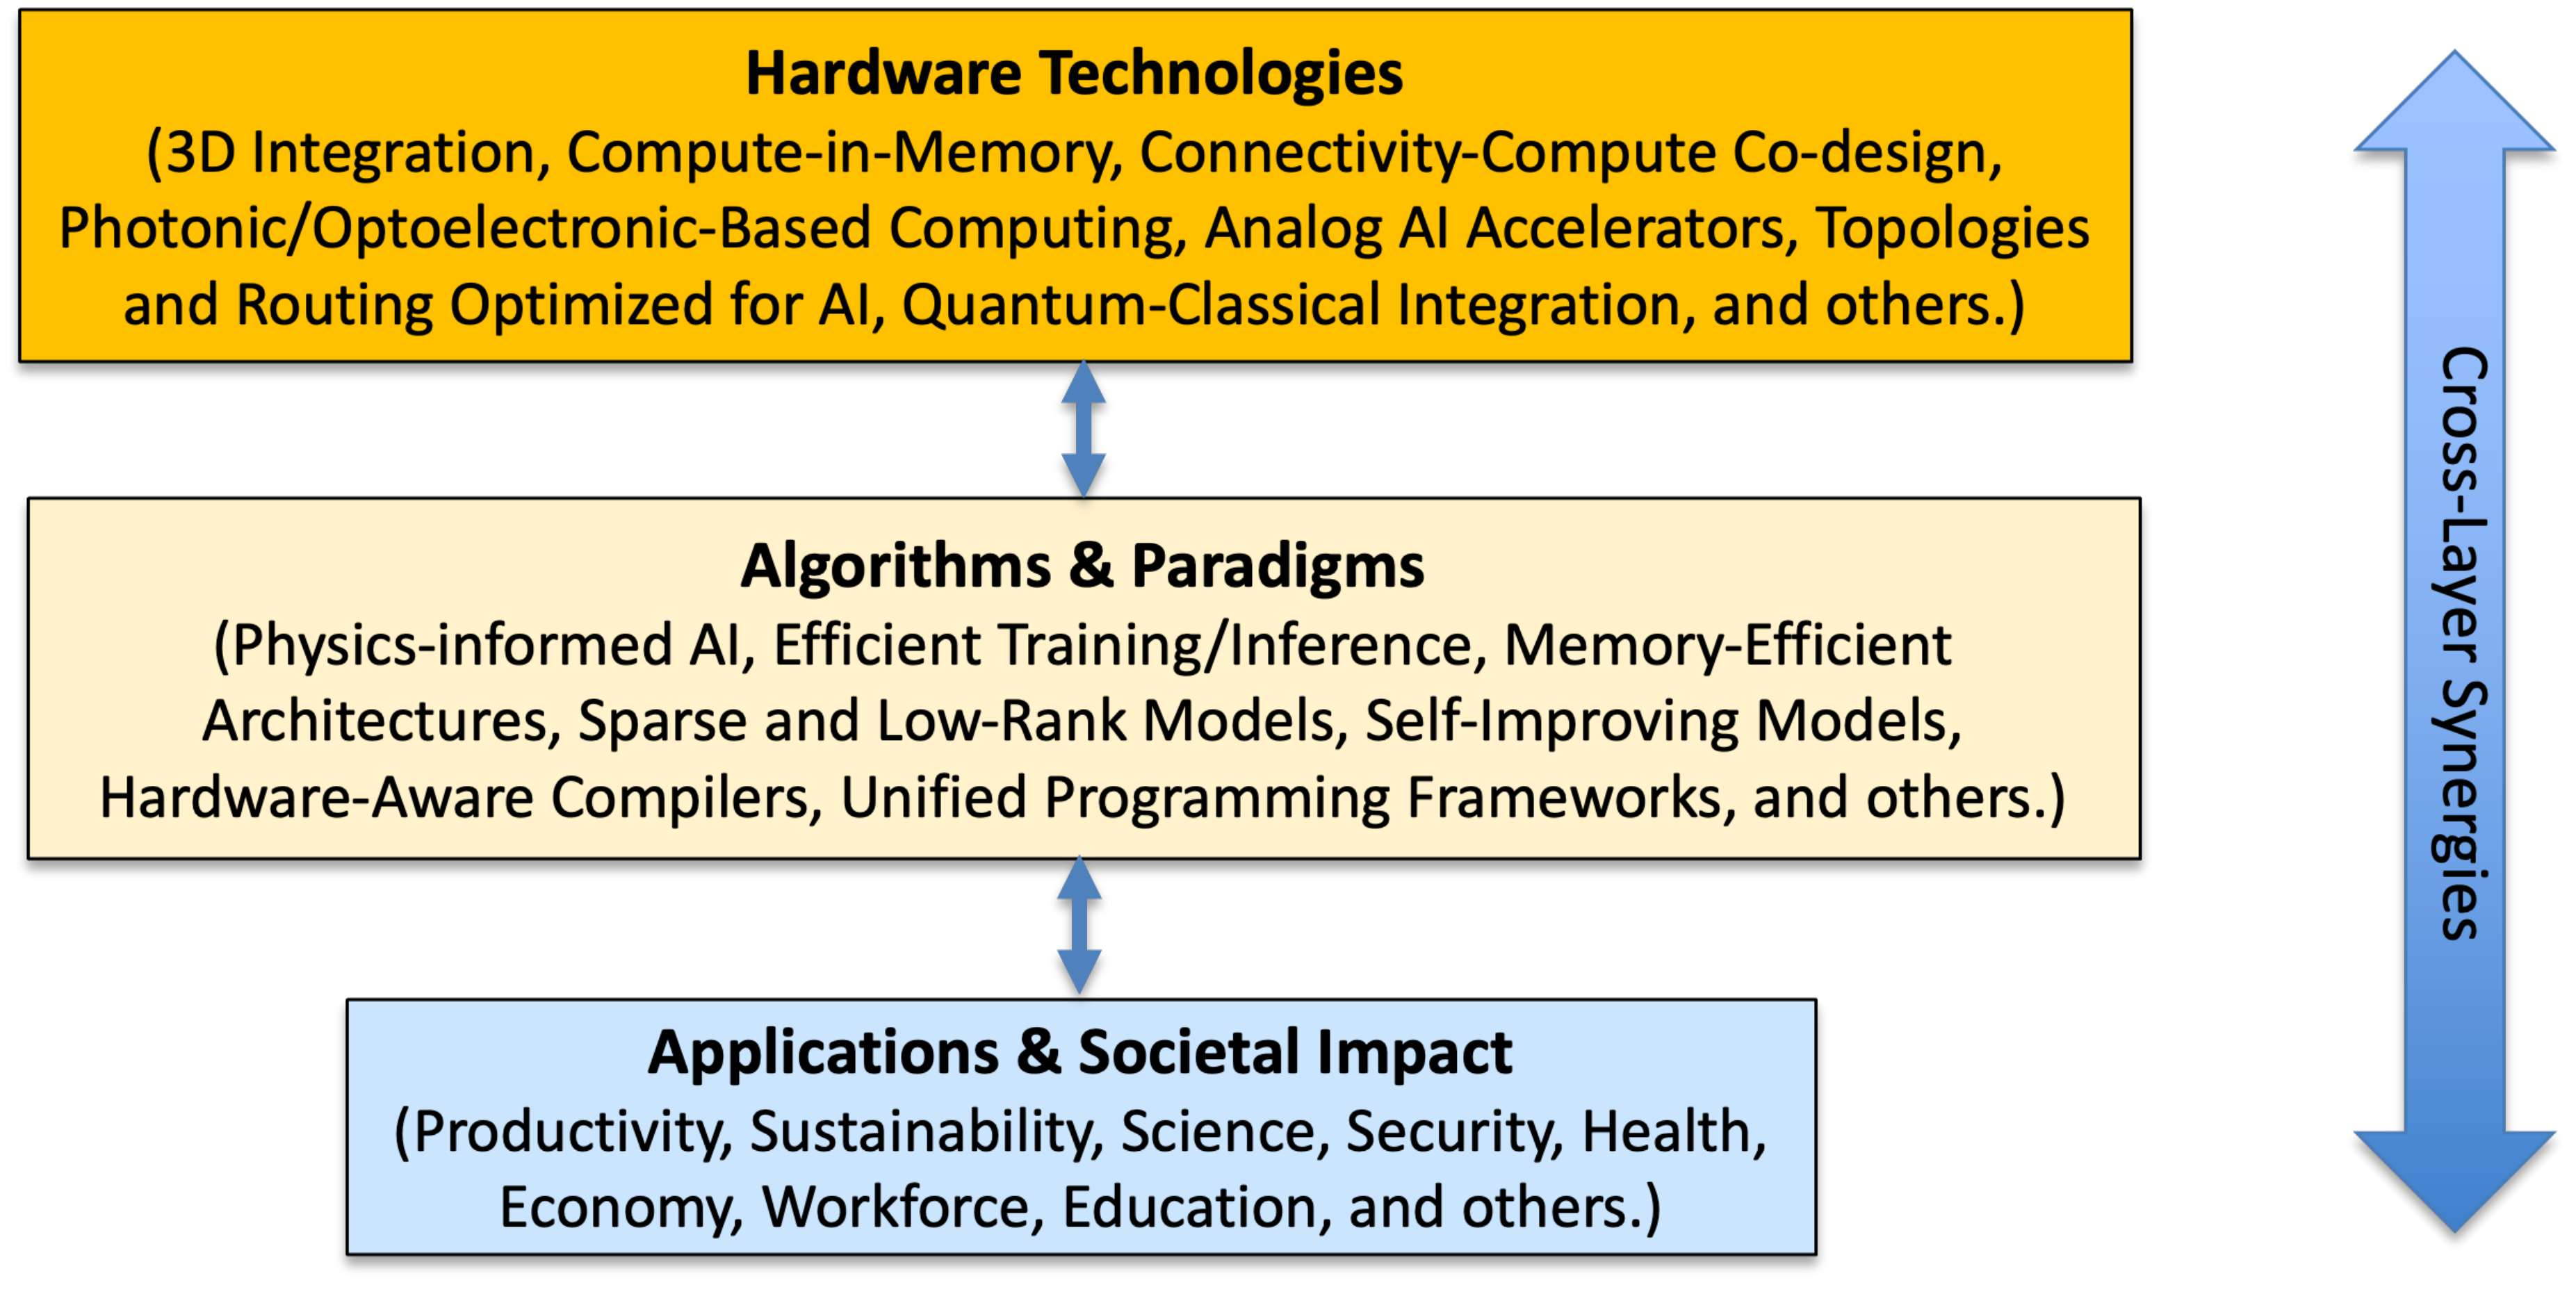 Figure 1: A Multi-Layered Vision for AI+HW Co-Design and Co-Evolution
| 계층 | 역할 | 주요 방향 |
|---|---|---|
| Hardware Technologies (하드웨어) | AI 시스템의 성능·에너지·확장성 경계를 정의하고, 어떤 알고리즘이 실현 가능한지를 결정 | 메모리 중심 구조, 3D 집적, compute-in-memory, 포토닉스 인터커넥트, 양자-고전 통합, AI 기반 EDA |
| Algorithms and Paradigms (알고리즘) | 하드웨어의 제약과 기회를 효율적인 학습·추론 방법으로 번역 | 하드웨어 인지 학습, 저정밀·희소성, AI-in-the-loop 설계 자동화, 물리 정보 학습, JEPA(Joint Embedding Predictive Architecture, 입력을 잠재 공간에 embedding한 뒤 그 공간에서 미래를 예측하는 구조) 같은 잠재 세계 모델 |
| Applications and Societal Impact (응용) | 실제 요구사항을 통해 위 두 계층에 새로운 제약과 목표를 부과 | 도메인 특화 AI, 엣지-클라우드 하이브리드, 지속가능성, 형평성 |
루프가 도는 방식은 이렇다. 하드웨어 발전이 알고리즘의 가능 영역을 넓히고 → 알고리즘이 그 가능성을 실제 효율로 바꾸고 → 응용이 에너지·지연시간·견고성·해석가능성·비용에 대한 구체적 요구를 만들어 다시 위 두 계층의 설계 목표가 된다. 동시에 AI가 하드웨어를 설계하고, 그 하드웨어가 다시 AI를 가속하는 순환도 함께 돈다.
논문이 반복해서 강조하는 것은 어느 한 계층의 돌파만으로는 부족하다 는 점이다. 데이터 이동, 에너지 최적화, 프로그래밍 용이성 같은 문제들이 지금까지 별개의 관심사로 취급되어 온 것이 근본 문제라는 것이다.
Table 1: 12개 세부 계층 지도
논문에서 실무적으로 가장 쓸모 있는 부분은 Table 1이다. 위 3계층을 12개의 세부 계층으로 쪼개고, 각각의 핵심 기술과 난제를 정리했다. 아래는 이를 한국어로 재구성한 것이다.
| 세부 계층 | 핵심 기술 / 트렌드 | 왜 중요한가 / 난제 |
|---|---|---|
| 소자·소재 (Device / Materials) | CMOS 너머 신소재(GaN, 탄소나노튜브, 2D 소재), 포토닉·광전 in-network 컴퓨팅, 극저온·초전도 소자, MRAM·RRAM·PCM 너머의 비휘발성 메모리 | 수율, 소자 편차, 신뢰성, 비용, 생태계 성숙도. 특히 비선형성·노이즈·드리프트가 대규모 crossbar 구현의 미해결 장벽 |
| 3D 집적·이종 패키징 | 3D monolithic 집적, die stacking, 칩렛, 저오버헤드 인터페이스 프로토콜, 고대역폭 인터포저 | 메모리 벽 완화의 핵심. 단 발열 관리, 전력 공급, 수율, 설계 복잡도, 테스트 용이성, 비트당 비용이 과제 |
| 아날로그·혼성신호·In-Memory | compute-in-memory(CIM), 근접 메모리 연산, 아날로그 AI 가속기(멤리스터, 저항성 crossbar), 하이브리드 디지털-아날로그 행렬곱 | 데이터 이동 비용을 근본적으로 줄임. 대신 노이즈, 비선형성, 정밀도, 캘리브레이션 문제. 통계적 오차 보상 기법이 필요 |
| 포토닉스·광 인터커넥트 | 칩 간·칩 내 광 인터커넥트, 광학 행렬곱 가속기, 전기-광 co-design | 낮은 지연, 높은 대역폭, 일부 영역에서 전력 절감. 전자회로와의 통합이 최대 난제 |
| 냉각·전력 공급 | 직접 액체·침지·미세유체 냉각, 온다이 레귤레이션, 후면 전력 공급(backside power delivery), AI 기반 런타임 열·전력 통합 관리 | 전력과 열이 이제 AI 성능·확장성·신뢰성의 직접적 상한선. 시스템 복잡도와 배치 비용이 과제 |
| 가속기 아키텍처 | 도메인 특화 가속기(텐서코어, NPU, IPU), 희소성·양자화·저정밀 구조, 재구성형 구조(FPGA, CGRA), 이종 구조 | 워크로드 맞춤이 큰 이득을 주지만 프로그래밍 용이성과 유연성이 계속 걸림돌 |
| 메모리·스토리지 계층 | HBM과 그 후속, CPU-가속기 통합 메모리 모델, 신규 메모리와 플래시 하이브리드, 메모리 압축·티어링, 영속 메모리 | 메모리 벽은 상시 과제. 최고 대역폭을 연산 가까이 두고, 저렴하고 느린 계층이 큰 모델을 받쳐야 함 |
| 인터커넥트·네트워킹 | 고처리량·저지연·워크로드 인지 인터커넥트, AI에 최적화된 토폴로지와 라우팅(all-to-all, collective 연산) | 모델이 여러 칩·노드에 걸치면 인터커넥트 지연·대역폭·조율 오버헤드가 지배적이 됨 |
| 시스템·인프라 | 연결성-연산 co-design, 랙 스케일·모듈형 시스템, 자원 분리(disaggregation), 전력·냉각 설계, 엣지 온디바이스 플랫폼 | 전력·발열·폼팩터 제약이 구조적 트레이드오프를 강제. 잘 다루지 못하면 신뢰성이 최대 100배까지 나빠질 수 있음(예: silent data corruption) |
| 컴파일러·런타임 | 하드웨어 인지 컴파일러와 자동 튜너, 최적화 커널 라이브러리, 통합 프로그래밍 프레임워크, 이종 유닛 간 런타임 스케줄링 | 소프트웨어 지원이 부실하면 이종·메모리 중심 시스템에서 심각한 자원 저활용 발생 |
| 프로그래밍 추상화·API | 표준 API, 중간 표현(IR) 전략, AI용 도메인 특화 언어, 모델-하드웨어 컴파일 | 현재 추상화와 이종·메모리 중심 시스템 사이의 큰 불일치. 이식성과 하드웨어 인지 사이 균형이 과제 |
| 알고리즘·모델 | ARC(Accuracy-Robustness-Complexity) 트레이드오프 탐색, 희소·저랭크·구조화 모델, 양자화·가지치기, 연합·온디바이스·지속 학습, 자기개선 모델, 불확실성 보정 모델 | 하드웨어 이득만으로는 모델 규모 증가를 따라갈 수 없음. 알고리즘이 연산과 메모리를 더 효율적으로 써야 함 |
이 표의 가치는 개별 항목보다 계층 간의 결합 을 명시적으로 드러냈다는 데 있다. 예를 들어 3D 집적(2행)은 메모리 계층(7행)의 난제를 풀기 위한 수단이고, 이때 발생하는 발열은 냉각(5행)의 문제가 되며, 아날로그 CIM(3행)이 만드는 노이즈는 알고리즘(12행)의 견고성으로 흡수되어야 한다. 한 줄만 봐서는 보이지 않는 연결이다.
사일로에서 시너지로
논문은 계층 내부의 발전만으로는 부족하고 cross-layer co-design 이 필요하다고 강조한다. 몇 가지 구체적인 예가 제시된다.
- 에너지 최적화: 종단 간 에너지를 최적화하려면 모델 구조부터 칩 레이아웃, 런타임 스케줄링, 심지어 냉각 전략까지를 하나로 잇는 통합 추상화가 필요하다.
- 신뢰성: 형식 검증, 물리 정보 기반 복원력, 보안 연산을 소프트웨어의 사후 처리가 아니라 하드웨어 수준에서 내재화해야 한다.
- 설계 생산성: AI 모델을 하드웨어 생성·검증·시뮬레이션에 활용하면 개념에서 시제품까지의 주기를 수년에서 수개월 또는 수주로 줄일 수 있다. 여기에는 개방 데이터셋, 모듈형 시뮬레이터, 표준 벤치마크(논문은 ITBench, IMC-Bench, CVDP Bench를 예로 든다)가 뒷받침되어야 한다.
논문은 또한 이 분야의 연구 생태계가 이미 형성되고 있다는 점도 언급한다. MLCAD, MLSys, ICLAD 같은 전용 학회가 자리를 잡았고, DAC·MICRO·ISCA·ASPLOS·ISSCC 같은 기존 주요 학회에도 AI 기반 하드웨어 설계와 하드웨어 인지 AI 알고리즘 트랙이 늘고 있다.
내 관점에서
이 논문을 읽으며 가장 인상 깊었던 것은 “scaling”이라는 단어의 의미를 바꾸자 는 제안 자체다. 지난 몇 년간 이 업계의 기본 문법은 “더 크게”였고, 효율은 그 다음 문제였다. intelligence per joule을 1급 지표로 올리자는 것은 단순한 구호가 아니라 평가 기준을 바꾸자는 것이고, 평가 기준이 바뀌면 연구의 방향도 바뀐다.
실무자 입장에서 Table 1은 특히 유용하다. 우리는 보통 자기 계층의 언어로만 문제를 정의한다. 알고리즘 하는 사람은 정확도와 학습 시간으로, 시스템 하는 사람은 처리량과 지연시간으로 말한다. 이 표는 그 사이의 번역기 역할을 한다. 내 문제가 사실은 두 계층 아래의 물리적 제약에서 온 것임을 알아차리게 해주는 종류의 지도다.
다만 비전 페이퍼의 한계도 분명하다. 30인의 합의문이다 보니 “무엇을 하지 말아야 하는가”에 대한 이야기가 거의 없다. 모든 유망한 방향이 다 들어가 있어서, 우선순위를 판단하는 일은 결국 읽는 사람의 몫으로 남는다.
다음 편에서는 하드웨어 계층(논문 3장)을 다룬다. 메모리 벽, 3D 집적, compute-in-memory, 포토닉스가 각각 어느 시점에 어디까지 올 것으로 예측되는지가 핵심이다.
- 다음: AI+HW 2035 (2) — 하드웨어 계층
- 원문: AI+HW 2035: Shaping the Next Decade (arXiv:2603.05225)